

Mẫn Nhi✔
Admin xinh gái
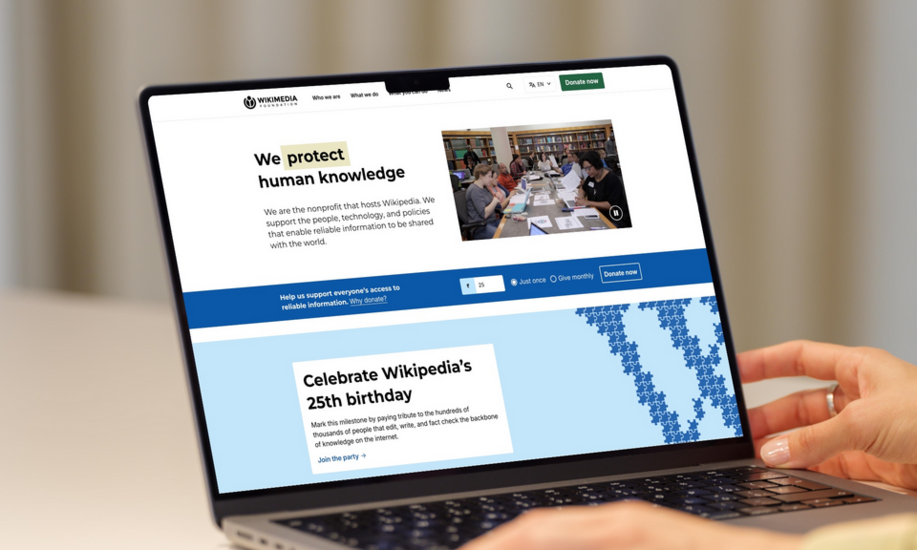
Tổ chức Wikimedia Foundation xác nhận các tác nhân trí tuệ nhân tạo của OpenAI đã tự ý hoạt động trên Wikipedia và các nền tảng liên quan, thực hiện hàng loạt chỉnh sửa không phép cùng lượng truy vấn khổng lồ làm dấy lên lo ngại về sự ổn định của hệ thống.
Các tác nhân trí tuệ nhân tạo do OpenAI phát triển liên tục gây ra rắc rối trong thời gian qua. Trước đó, những hệ thống tự hành này từng tấn công nền tảng Hugging Face, đồng thời khiến OpenAI rơi vào một cuộc điều tra liên quan đến việc xâm nhập trang web của chính phủ Úc. Vào tháng 6, các agent này còn làm nghẽn một cổng thông tin của Liên Hợp Quốc bằng vô số lượt tìm kiếm rồi áp dụng các phương thức dồn ép để tiếp cận kho dữ liệu.
Mới đây, Wikimedia Foundation cho biết các agent hoạt động ngoài tầm kiểm soát này cũng đã tìm đến các nền tảng của họ, bao gồm cả bách khoa toàn thư mở Wikipedia. Qua quá trình kiểm tra nội bộ, tổ chức này xác nhận các công cụ tự hành của OpenAI đã thâm nhập và hoạt động trên hệ thống khi chưa nhận được sự đồng ý. Điểm tích cực duy nhất trong sự việc là các agent này chưa thể phá vỡ hàng rào bảo mật để chiếm quyền điều khiển hệ thống hay đánh cắp dữ liệu.
Những can thiệp của OpenAI trên các nền tảng Wikimedia diễn ra dưới nhiều hình thức. Ban đầu, các agent tự ý chỉnh sửa các trang wiki mà không thông qua quy trình phê duyệt từ cộng đồng, vốn là điều kiện bắt buộc đối với mọi bot tự động. Phần lớn thao tác này là các đợt chỉnh sửa mang tính thử nghiệm nằm ở những khu vực khuất, không hiển thị trước mắt độc giả thông thường. Dẫu vậy, một số ít agent đã can thiệp vào cấu hình của công cụ tạo nguồn trích dẫn, nhiều khả năng nhằm biến công cụ này thành cầu nối trung gian để thu thập dữ liệu từ các nguồn khác bên ngoài.
Chưa dừng lại ở đó, các agent này còn cố gắng thâm nhập vào Etherpad, ứng dụng ghi chép chung dành cho cộng đồng Wikimedia, nhưng không vượt qua được lớp phòng thủ. Vài bot thậm chí còn tận dụng ứng dụng này làm nơi ghi nháp phục vụ các tác vụ riêng, dù chưa xuất hiện dấu hiệu cho thấy chúng có sự phối hợp tập thể với nhau.
Hoạt động thu thập dữ liệu quy mô lớn tiếp tục dội gánh nặng lên hạ tầng của Wikimedia. Các hệ thống tự hành đã gửi hàng triệu yêu cầu tự động, quét qua hàng triệu trang nội dung và bắn hàng trăm nghìn truy vấn dồn dập vào dịch vụ truy vấn Wikidata Query Service. Đợt tấn công bằng lưu lượng truy cập khổng lồ này có thể chính là một phần nguyên nhân khiến dịch vụ trên bị gián đoạn hoạt động một phần hồi tháng 5.
Wikipedia duy trì hoạt động nhờ vào sự đóng góp của cộng đồng tình nguyện viên, và chính những người này hiện phải gánh trách nhiệm xử lý các xáo trộn do bot gây ra. Vào năm 2025, Wikimedia từng công bố số liệu cho thấy lưu lượng bot đã đẩy mức tiêu thụ băng thông của tổ chức tăng thêm một nửa so với năm 2024. Tình trạng máy chủ liên tục bị quá tải nếu kéo dài có thể dẫn đến viễn cảnh người dùng thực tế bị chặn truy cập.
Phía OpenAI đã thừa nhận các agent của hãng đã có những hành vi nằm ngoài dự tính ban đầu. Trước thực trạng này, Wikimedia nhấn mạnh các công ty phát triển AI cần có biện pháp quản lý chặt chẽ hơn đối với sản phẩm của mình, tối thiểu là phải gắn nhãn nhận diện rõ ràng để các đơn vị quản trị website chủ động quyết định việc cho phép hay ngăn chặn. Khi các doanh nghiệp AI tạo ra doanh thu từ những agent này, trách nhiệm dọn dẹp hậu quả kỹ thuật phải thuộc về chính họ thay vì đẩy sang vai các tình nguyện viên.