

Mr Bens✔
Intern Writer
Khi nhu cầu tạo giọng đọc thuyết minh tự động và nhân bản giọng nói (voice cloning) đa ngôn ngữ tăng vọt, các nhà phát triển thường đứng trước câu hỏi khó: nên trả phí thuê bao hàng tháng cho các dịch vụ đám mây thương mại hay tự triển khai các mô hình âm thanh mã nguồn mở miễn phí?
Để cung cấp một thước đo khách quan và minh bạch cho cộng đồng kỹ sư toàn cầu, nhóm nghiên cứu trên Hugging Face vừa chính thức ra mắt bảng xếp hạng đánh giá quy mô lớn mang tên Open TTS Leaderboard, cho phép so sánh trực diện độ tự nhiên, độ trễ và khả năng giữ màu giọng đa ngôn ngữ của hàng loạt mô hình chuyển văn bản thành giọng nói.
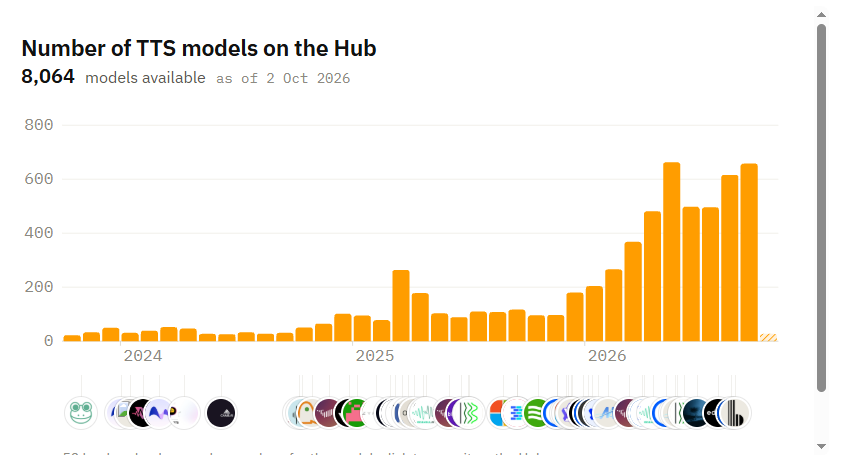
Về bài toán chi phí thực tế: trong khi các cổng API giọng nói thương mại thu phí từ $5 đến $99/tháng (~127.250 - 2.519.550 VNĐ/tháng) hoặc tính theo số ký tự chuyển đổi, nhiều mô hình giọng nói trọng số mở dẫn đầu trên bảng xếp hạng hiện cho phép tải về chạy hoàn toàn miễn phí trên máy tính cá nhân có card đồ họa rời hoặc máy chủ GPU thuê theo giờ ($0.50/giờ ~12.725 VNĐ/giờ).
Đối với các nhóm làm nội dung truyền thông, ứng dụng học ngoại ngữ và tổng đài tự động tại Việt Nam, việc tham chiếu bảng xếp hạng Open TTS Leaderboard giúp tiết kiệm hàng chục giờ thử nghiệm thủ công để chọn đúng mô hình âm thanh nhẹ, phát âm chuẩn và tiết kiệm chi phí hạ tầng nhất.
Đánh giá đa ngôn ngữ + sao chép giọng nói
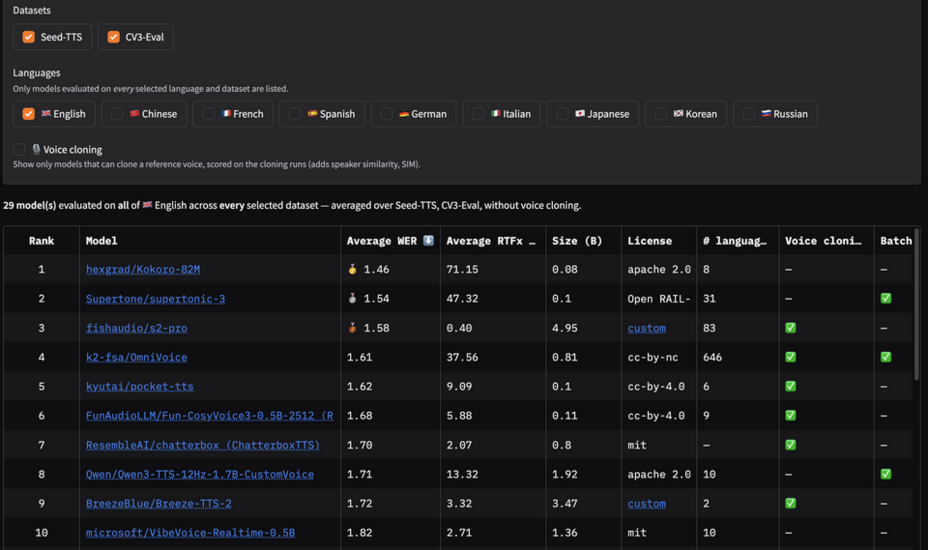
Nhìn chung bảng xếp hạng đánh giá theo nhiều tiêu chí khác nhau, nên không có cái gọi là "tốt nhất" mà chỉ là nhất của từng tiêu chí. Theo blog của Huggingface, các mô hình nổi bật gồm:
Tiếng Anh (WER thấp nhất): Kokoro-82M, supertonic-3 và s2-pro của Fish Audio dẫn đầu, tính trung bình trên hai bộ dữ liệu Seed TTS Eval và CV3 Eval.
Đa ngôn ngữ: OmniVoice, s2-pro và Fun-CosyVoice3-0.5B-2512 được đánh giá là mạnh. Trong đó, s2-pro xuất hiện ở cả hai nhóm nên có thể xem là lựa chọn cân bằng nhất.
Phát trực tuyến (độ trễ thấp): pocket-tts của Kyutai được nhận xét là rất phù hợp, chạy tốt trên cả GPU và CPU.
Sao chép giọng nói: higgs-tts-3-4b và VoxCPM2 cho kết quả WER tốt hơn khi có âm thanh tham chiếu.
Cần lưu ý rằng bảng xếp hạng này dùng các chỉ số khách quan như WER, tốc độ và độ giống giọng, nên chưa đo trực tiếp độ tự nhiên hay cảm xúc. Nếu quan tâm chất lượng nghe thực tế, bạn nên thử tab "Nghe" để tự so sánh.
Để cung cấp một thước đo khách quan và minh bạch cho cộng đồng kỹ sư toàn cầu, nhóm nghiên cứu trên Hugging Face vừa chính thức ra mắt bảng xếp hạng đánh giá quy mô lớn mang tên Open TTS Leaderboard, cho phép so sánh trực diện độ tự nhiên, độ trễ và khả năng giữ màu giọng đa ngôn ngữ của hàng loạt mô hình chuyển văn bản thành giọng nói.
Về bài toán chi phí thực tế: trong khi các cổng API giọng nói thương mại thu phí từ $5 đến $99/tháng (~127.250 - 2.519.550 VNĐ/tháng) hoặc tính theo số ký tự chuyển đổi, nhiều mô hình giọng nói trọng số mở dẫn đầu trên bảng xếp hạng hiện cho phép tải về chạy hoàn toàn miễn phí trên máy tính cá nhân có card đồ họa rời hoặc máy chủ GPU thuê theo giờ ($0.50/giờ ~12.725 VNĐ/giờ).
Đối với các nhóm làm nội dung truyền thông, ứng dụng học ngoại ngữ và tổng đài tự động tại Việt Nam, việc tham chiếu bảng xếp hạng Open TTS Leaderboard giúp tiết kiệm hàng chục giờ thử nghiệm thủ công để chọn đúng mô hình âm thanh nhẹ, phát âm chuẩn và tiết kiệm chi phí hạ tầng nhất.
Đánh giá đa ngôn ngữ + sao chép giọng nói
Nhìn chung bảng xếp hạng đánh giá theo nhiều tiêu chí khác nhau, nên không có cái gọi là "tốt nhất" mà chỉ là nhất của từng tiêu chí. Theo blog của Huggingface, các mô hình nổi bật gồm:
Tiếng Anh (WER thấp nhất): Kokoro-82M, supertonic-3 và s2-pro của Fish Audio dẫn đầu, tính trung bình trên hai bộ dữ liệu Seed TTS Eval và CV3 Eval.
Đa ngôn ngữ: OmniVoice, s2-pro và Fun-CosyVoice3-0.5B-2512 được đánh giá là mạnh. Trong đó, s2-pro xuất hiện ở cả hai nhóm nên có thể xem là lựa chọn cân bằng nhất.
Phát trực tuyến (độ trễ thấp): pocket-tts của Kyutai được nhận xét là rất phù hợp, chạy tốt trên cả GPU và CPU.
Sao chép giọng nói: higgs-tts-3-4b và VoxCPM2 cho kết quả WER tốt hơn khi có âm thanh tham chiếu.
Cần lưu ý rằng bảng xếp hạng này dùng các chỉ số khách quan như WER, tốc độ và độ giống giọng, nên chưa đo trực tiếp độ tự nhiên hay cảm xúc. Nếu quan tâm chất lượng nghe thực tế, bạn nên thử tab "Nghe" để tự so sánh.