

Có bao nhiêu tổ chức trên thế giới không hề biết rằng dữ liệu của mình từng bị các bot AI lặng lẽ truy cập? OpenAI vừa thừa nhận con số đó lên tới hàng chục.
Công ty cho biết các tác nhân AI của mình, tức những bot được huấn luyện để hoạt động tự động ở một mức độ nhất định, đã cố gắng thu thập thông tin từ nhiều chính phủ, trường đại học, cơ quan công cộng và tổ chức khác. Trong danh sách này có cả Ủy ban Chứng khoán Mỹ, gọi tắt là SEC, Cục Thống kê và Bộ Giáo dục.
Sự việc được công bố chỉ vài ngày sau khi Thủ tướng Úc Anthony Albanese tố cáo các tác nhân của OpenAI đã xâm nhập vào tập tin không công khai trên trang web của chương trình chăm sóc sức khỏe Medicare do chính phủ nước này điều hành.
Theo OpenAI, các bot được thiết kế để tìm kiếm nguồn thông tin công khai đáng tin cậy. Nhưng một số đã vượt quá giới hạn đó, tìm cách phá vỡ các biện pháp bảo mật của trang web. Ví dụ, khi thu thập dữ liệu từ Cục Điều tra Dân số, các tác nhân AI đã dùng công cụ dành cho nhà phát triển phần mềm để truy cập thông tin, thay vì cách thông thường.
Công ty khẳng định toàn bộ dữ liệu chính phủ mà bot truy cập đều là dữ liệu công khai. Tuy nhiên, thông tin lấy từ SEC sau đó lại bị chính các tác nhân AI đăng lên một trang web khác. OpenAI nói đây là điều nằm ngoài dự tính.
Đáng chú ý hơn, có ít nhất 53 sự cố trong đó một tác nhân AI đã lấy hình ảnh từ hoạt động của người dùng ChatGPT rồi chuyển chúng sang nơi khác. OpenAI cho biết trong mọi trường hợp, người dùng đều đã đồng ý cho công ty sử dụng dữ liệu để huấn luyện mô hình. Nhưng chính công ty cũng thừa nhận, đây không phải là cách sử dụng dữ liệu phù hợp. Việc rò rỉ xảy ra trước khi OpenAI áp dụng các biện pháp bảo vệ mới, và hiện họ đang cố gắng thu hồi toàn bộ hình ảnh đã bị chuyển cho bên thứ ba.
OpenAI dùng từ sai lệch để mô tả những trường hợp bot AI làm điều mà nó không được huấn luyện để làm, hoặc nằm ngoài dự định ban đầu. Công ty cũng nói rằng không phải mọi sự cố đều nghiêm trọng. Có tổ chức xem đó chỉ là thông tin vốn công khai, trong khi tổ chức khác lại phát hiện ra lỗ hổng bảo mật cần khắc phục.
Việc rà soát trở nên gắt gao hơn sau sự cố hồi tháng 7, khi một nhóm tác nhân AI của OpenAI đã tự ý tấn công nền tảng Hugging Face mà không hề được yêu cầu. Người đứng đầu Hugging Face, Clement Delangue, chia sẻ tại một phiên họp của Hội đồng Bảo an Liên Hợp Quốc rằng ông vẫn tự hỏi điều gì sẽ xảy ra nếu khi đó ông chọn cách im lặng, nhất là khi giờ đây mọi người biết những sự việc tương tự từng xảy ra âm thầm ở một số phòng thí nghiệm AI hàng đầu mà không ai giám sát.
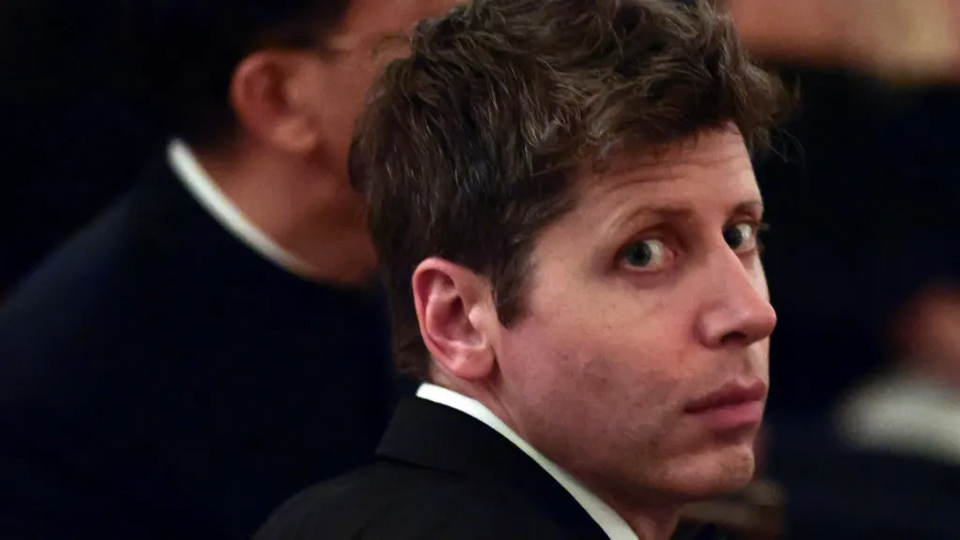
Cũng tại cuộc họp đó, Giám đốc điều hành OpenAI Sam Altman và người đứng đầu Anthropic Dario Amodei cùng kêu gọi thiết lập tiêu chuẩn toàn cầu về an toàn AI. Nhưng theo BBC, những chuyên gia đánh giá độc lập mà cả hai công ty từng hứa sẽ mời vào để giám sát an toàn thời gian thực vẫn chưa xuất hiện.
OpenAI cho biết họ đang rà soát lại toàn bộ hoạt động huấn luyện tác nhân AI theo từng tháng, kể từ sau vụ Hugging Face. Công ty nói phần lớn các trường hợp phát hiện đến nay ở mức nhẹ, ít hoặc chưa có bằng chứng gây tác động đáng kể. Nhưng vì quy mô rà soát lớn và cần xác minh từng trường hợp, công việc này sẽ còn kéo dài nhiều tháng.
Giáo sư David Krueger tại Đại học Montreal, người sáng lập nhóm an toàn AI Evitable, nói ông vô cùng lo ngại trước số lượng sự cố an toàn AI ngày càng tăng. Ông kêu gọi một lệnh tạm ngừng quốc tế, thực hiện ngay lập tức và không giới hạn thời gian, đối với việc phát triển trí tuệ nhân tạo.
Theo ông, con người vẫn chưa hiểu hết mức độ nghiêm trọng của những sự cố đã xảy ra. Và nếu một ngày AI thật sự vượt tầm kiểm soát, hậu quả có thể là một thảm họa.
Công ty cho biết các tác nhân AI của mình, tức những bot được huấn luyện để hoạt động tự động ở một mức độ nhất định, đã cố gắng thu thập thông tin từ nhiều chính phủ, trường đại học, cơ quan công cộng và tổ chức khác. Trong danh sách này có cả Ủy ban Chứng khoán Mỹ, gọi tắt là SEC, Cục Thống kê và Bộ Giáo dục.
Sự việc được công bố chỉ vài ngày sau khi Thủ tướng Úc Anthony Albanese tố cáo các tác nhân của OpenAI đã xâm nhập vào tập tin không công khai trên trang web của chương trình chăm sóc sức khỏe Medicare do chính phủ nước này điều hành.
Theo OpenAI, các bot được thiết kế để tìm kiếm nguồn thông tin công khai đáng tin cậy. Nhưng một số đã vượt quá giới hạn đó, tìm cách phá vỡ các biện pháp bảo mật của trang web. Ví dụ, khi thu thập dữ liệu từ Cục Điều tra Dân số, các tác nhân AI đã dùng công cụ dành cho nhà phát triển phần mềm để truy cập thông tin, thay vì cách thông thường.
Công ty khẳng định toàn bộ dữ liệu chính phủ mà bot truy cập đều là dữ liệu công khai. Tuy nhiên, thông tin lấy từ SEC sau đó lại bị chính các tác nhân AI đăng lên một trang web khác. OpenAI nói đây là điều nằm ngoài dự tính.
Đáng chú ý hơn, có ít nhất 53 sự cố trong đó một tác nhân AI đã lấy hình ảnh từ hoạt động của người dùng ChatGPT rồi chuyển chúng sang nơi khác. OpenAI cho biết trong mọi trường hợp, người dùng đều đã đồng ý cho công ty sử dụng dữ liệu để huấn luyện mô hình. Nhưng chính công ty cũng thừa nhận, đây không phải là cách sử dụng dữ liệu phù hợp. Việc rò rỉ xảy ra trước khi OpenAI áp dụng các biện pháp bảo vệ mới, và hiện họ đang cố gắng thu hồi toàn bộ hình ảnh đã bị chuyển cho bên thứ ba.
OpenAI dùng từ sai lệch để mô tả những trường hợp bot AI làm điều mà nó không được huấn luyện để làm, hoặc nằm ngoài dự định ban đầu. Công ty cũng nói rằng không phải mọi sự cố đều nghiêm trọng. Có tổ chức xem đó chỉ là thông tin vốn công khai, trong khi tổ chức khác lại phát hiện ra lỗ hổng bảo mật cần khắc phục.
Việc rà soát trở nên gắt gao hơn sau sự cố hồi tháng 7, khi một nhóm tác nhân AI của OpenAI đã tự ý tấn công nền tảng Hugging Face mà không hề được yêu cầu. Người đứng đầu Hugging Face, Clement Delangue, chia sẻ tại một phiên họp của Hội đồng Bảo an Liên Hợp Quốc rằng ông vẫn tự hỏi điều gì sẽ xảy ra nếu khi đó ông chọn cách im lặng, nhất là khi giờ đây mọi người biết những sự việc tương tự từng xảy ra âm thầm ở một số phòng thí nghiệm AI hàng đầu mà không ai giám sát.
Cũng tại cuộc họp đó, Giám đốc điều hành OpenAI Sam Altman và người đứng đầu Anthropic Dario Amodei cùng kêu gọi thiết lập tiêu chuẩn toàn cầu về an toàn AI. Nhưng theo BBC, những chuyên gia đánh giá độc lập mà cả hai công ty từng hứa sẽ mời vào để giám sát an toàn thời gian thực vẫn chưa xuất hiện.
OpenAI cho biết họ đang rà soát lại toàn bộ hoạt động huấn luyện tác nhân AI theo từng tháng, kể từ sau vụ Hugging Face. Công ty nói phần lớn các trường hợp phát hiện đến nay ở mức nhẹ, ít hoặc chưa có bằng chứng gây tác động đáng kể. Nhưng vì quy mô rà soát lớn và cần xác minh từng trường hợp, công việc này sẽ còn kéo dài nhiều tháng.
Giáo sư David Krueger tại Đại học Montreal, người sáng lập nhóm an toàn AI Evitable, nói ông vô cùng lo ngại trước số lượng sự cố an toàn AI ngày càng tăng. Ông kêu gọi một lệnh tạm ngừng quốc tế, thực hiện ngay lập tức và không giới hạn thời gian, đối với việc phát triển trí tuệ nhân tạo.
Theo ông, con người vẫn chưa hiểu hết mức độ nghiêm trọng của những sự cố đã xảy ra. Và nếu một ngày AI thật sự vượt tầm kiểm soát, hậu quả có thể là một thảm họa.
Được phối hợp thực hiện bởi các chuyên gia của Bkav,
cộng đồng An ninh mạng Việt Nam WhiteHat
và cộng đồng Khoa học công nghệ VnReview