

Mẫn Nhi✔
Admin xinh gái
xAI của Elon Musk đã chính thức giới thiệu Grok 4.7, hệ thống AI tân tiến nhất của hãng tính đến thời điểm hiện tại. Doanh nghiệp này mô tả sản phẩm mới là một sự nâng cấp đáng chú ý so với Grok 4.6 mà không làm tăng giá thành hay giảm tốc độ phản hồi.
Màn xuất hiện của phiên bản này diễn ra sau chuỗi ngày liên tục trì hoãn. Kể từ cuối tháng 7, Musk đã có ít nhất năm lần điều chỉnh mốc thời gian, khởi đầu từ lời hứa còn khoảng bốn tuần, sau đó chuyển thành vài tuần, rồi ba đến bốn tuần, rút xuống mười ngày vào ngày 1 tháng 9, trước khi tiếp tục thông báo vào ngày 11 tháng 9 rằng hệ thống cần thêm một vài ngày để hoàn thiện.
Theo công bố từ xAI, Grok 4.7 dành nhiều thời gian hơn để xử lý những vấn đề phức tạp và có tần suất tự kiểm tra lại các câu trả lời cao hơn so với bản 4.6, đồng thời tích hợp hệ thống rào chắn an toàn kiên cố nhất mà công ty từng xây dựng. Trên mạng xã hội X, Musk nhận định Grok 4.7 là sự kết hợp mạnh mẽ giữa trí thông minh, tốc độ và chi phí vận hành thấp. Lần phát hành này không yêu cầu danh sách chờ, người dùng có thể trải nghiệm ngay trên ứng dụng Grok, nền tảng Cursor, Grok Build cũng như giao diện lập trình ứng dụng xAI API.
Đáng chú ý, xAI đã bổ sung vào quá trình đào tạo nguồn dữ liệu phụ trợ thu thập từ công ty tên lửa SpaceX của Musk, bao gồm dữ liệu đo từ xa của vệ tinh Starlink, hồ sơ sản xuất và nhật ký các sự cố kỹ thuật. Định hướng của việc này là tạo ra một công cụ có khả năng suy luận về phần cứng cùng các hệ thống vật lý vượt trội hơn so với những mô hình chỉ đơn thuần học từ văn bản trên internet.
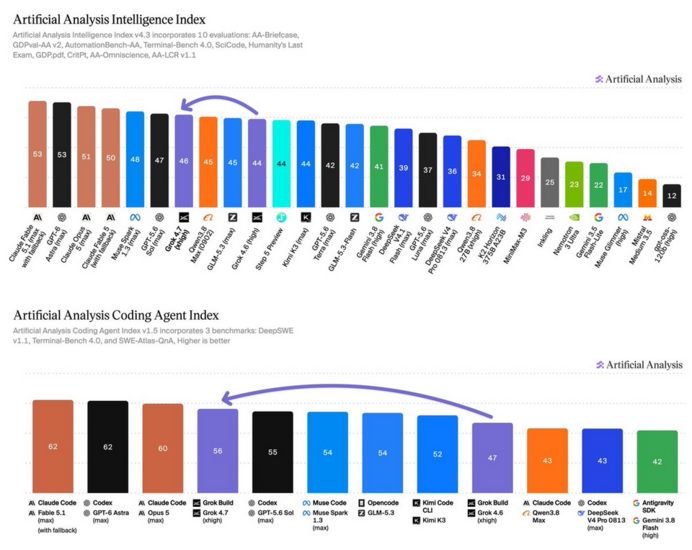
Dù có sự nâng cấp về cấu trúc, các bài kiểm tra hiệu năng vẫn phản ánh một kịch bản quen thuộc. Bài đo GDPval, vốn đánh giá năng lực thực hiện các công việc tri thức có giá trị kinh tế thực tế như soạn thảo văn bản pháp lý, bảng tính hay trang trình bày dựa trên các tác vụ do chuyên gia thẩm định và xếp hạng theo thang điểm Elo tương tự môn cờ vua, đã chấm Grok 4.7 đạt 1695 điểm. Trong khi đó, Claude Fable 5.1 tiếp tục giữ ngôi đầu bảng với 1735 điểm.
Tại bài thử nghiệm AA-Briefcase do Artificial Analysis thiết kế nhằm kiểm tra khả năng xử lý khối lượng công việc văn phòng kéo dài nhiều giờ kết hợp giữa nghiên cứu, phân tích và tạo tài liệu thành một chuỗi tác vụ liền mạch, Grok 4.7 ghi nhận 1657 điểm Elo, vẫn xếp sau mức 1678 điểm của Fable 5.1.
Ở bài đánh giá CursorBench 4.0, công cụ đo lường các tác vụ lập trình thực tế ngay trong trình soạn thảo Cursor thông qua việc đối chiếu độ chính xác với chi phí và số lượng token tiêu thụ, Grok 4.7 rơi vào nhóm giữa. Chi phí trên mỗi tác vụ của mô hình này đắt hơn so với GPT-6 Astra, thế hệ kế nhiệm GPT-5.6 Sol, cũng như Claude Sonnet 5, nhưng kết quả chung cuộc vẫn chưa thể bắt kịp Fable 5.1, cái tên áp đảo ở mọi phân khúc chi phí trên bảng so sánh.
Thực tế trên không đồng nghĩa Grok 4.7 là một giải pháp tồi đối với hàng triệu người đang tương tác qua mạng xã hội X, ứng dụng độc lập hay hệ thống điều khiển trên xe Tesla. Điều này chỉ cho thấy mô hình đang trực tiếp giải đáp thắc mắc hoặc vận hành trợ lý giọng nói trên xe của người dùng được phát triển từ một hệ thống mà theo các số liệu của chính đơn vị sản xuất, vẫn đang đứng dưới nấc thang cao nhất của thị trường.
Chênh lệch về năng lực giải thích vì sao mức giá lại là yếu tố trọng tâm hơn thứ hạng trên bảng xếp hạng đối với số đông. xAI liên tục đưa ra mức giá token thấp hơn Anthropic và OpenAI ngay cả khi đi sau về sức mạnh xử lý thuần túy. Hướng đi này dựa trên tính toán rằng một công cụ đủ tốt, giá thành rẻ và xuất hiện ở mọi nơi sẽ chiếm ưu thế trước một hệ thống tốt nhất nhưng đắt đỏ trong phần lớn nhu cầu thường nhật.
Bản thân Elon Musk cũng đã hạ thấp kỳ vọng của công chúng trước ngày ra mắt khi chia sẻ rằng Grok 4.7 chỉ nên được nhìn nhận ở mức tương đương với Claude Opus 5.0 của Anthropic thay vì bản nâng cấp Opus 5.1, đồng thời thừa nhận năng lực xử lý đa phương thức vẫn cần hoàn thiện thêm. Trong cùng thông điệp đó, ông đã phác thảo lộ trình cho ba thế hệ kế tiếp với Grok 4.8 là bước nhảy vọt đáng kể, Grok 4.9 sẽ bước vào cùng phân khúc với Astra và Fable, còn Grok 5 được kỳ vọng có thể vươn lên dẫn đầu làn sóng công nghệ mới. Dù vậy, những bản cập nhật tương lai này hiện vẫn chưa có lịch phát hành cụ thể và câu trả lời vẫn còn ở phía trước.
Màn xuất hiện của phiên bản này diễn ra sau chuỗi ngày liên tục trì hoãn. Kể từ cuối tháng 7, Musk đã có ít nhất năm lần điều chỉnh mốc thời gian, khởi đầu từ lời hứa còn khoảng bốn tuần, sau đó chuyển thành vài tuần, rồi ba đến bốn tuần, rút xuống mười ngày vào ngày 1 tháng 9, trước khi tiếp tục thông báo vào ngày 11 tháng 9 rằng hệ thống cần thêm một vài ngày để hoàn thiện.
Theo công bố từ xAI, Grok 4.7 dành nhiều thời gian hơn để xử lý những vấn đề phức tạp và có tần suất tự kiểm tra lại các câu trả lời cao hơn so với bản 4.6, đồng thời tích hợp hệ thống rào chắn an toàn kiên cố nhất mà công ty từng xây dựng. Trên mạng xã hội X, Musk nhận định Grok 4.7 là sự kết hợp mạnh mẽ giữa trí thông minh, tốc độ và chi phí vận hành thấp. Lần phát hành này không yêu cầu danh sách chờ, người dùng có thể trải nghiệm ngay trên ứng dụng Grok, nền tảng Cursor, Grok Build cũng như giao diện lập trình ứng dụng xAI API.
Nâng cấp thông số và nguồn dữ liệu đặc biệt từ SpaceX
Grok 4.7 sở hữu 2,1 nghìn tỷ tham số, tăng khoảng 40% so với quy mô 1,5 nghìn tỷ của Grok 4.6, phiên bản vốn là bản tinh chỉnh từ Grok 4.5. Mức giá dịch vụ được niêm yết ở ngưỡng 2 USD cho mỗi một triệu token đầu vào và 6 USD cho mỗi một triệu token đầu ra. Về mặt kỹ thuật, tham số là các biến số nội tại được mô hình tinh chỉnh xuyên suốt quá trình huấn luyện, nơi số lượng tham số lớn hơn thường mang lại khả năng nắm bắt quy luật tốt hơn, trong khi token đóng vai trò là đơn vị thông tin cơ bản để hệ thống tiếp nhận hoặc sản sinh dữ liệu.Đáng chú ý, xAI đã bổ sung vào quá trình đào tạo nguồn dữ liệu phụ trợ thu thập từ công ty tên lửa SpaceX của Musk, bao gồm dữ liệu đo từ xa của vệ tinh Starlink, hồ sơ sản xuất và nhật ký các sự cố kỹ thuật. Định hướng của việc này là tạo ra một công cụ có khả năng suy luận về phần cứng cùng các hệ thống vật lý vượt trội hơn so với những mô hình chỉ đơn thuần học từ văn bản trên internet.
Điểm chuẩn thực tế vẫn xếp sau các đối thủ
Dù có sự nâng cấp về cấu trúc, các bài kiểm tra hiệu năng vẫn phản ánh một kịch bản quen thuộc. Bài đo GDPval, vốn đánh giá năng lực thực hiện các công việc tri thức có giá trị kinh tế thực tế như soạn thảo văn bản pháp lý, bảng tính hay trang trình bày dựa trên các tác vụ do chuyên gia thẩm định và xếp hạng theo thang điểm Elo tương tự môn cờ vua, đã chấm Grok 4.7 đạt 1695 điểm. Trong khi đó, Claude Fable 5.1 tiếp tục giữ ngôi đầu bảng với 1735 điểm.
Tại bài thử nghiệm AA-Briefcase do Artificial Analysis thiết kế nhằm kiểm tra khả năng xử lý khối lượng công việc văn phòng kéo dài nhiều giờ kết hợp giữa nghiên cứu, phân tích và tạo tài liệu thành một chuỗi tác vụ liền mạch, Grok 4.7 ghi nhận 1657 điểm Elo, vẫn xếp sau mức 1678 điểm của Fable 5.1.
Ở bài đánh giá CursorBench 4.0, công cụ đo lường các tác vụ lập trình thực tế ngay trong trình soạn thảo Cursor thông qua việc đối chiếu độ chính xác với chi phí và số lượng token tiêu thụ, Grok 4.7 rơi vào nhóm giữa. Chi phí trên mỗi tác vụ của mô hình này đắt hơn so với GPT-6 Astra, thế hệ kế nhiệm GPT-5.6 Sol, cũng như Claude Sonnet 5, nhưng kết quả chung cuộc vẫn chưa thể bắt kịp Fable 5.1, cái tên áp đảo ở mọi phân khúc chi phí trên bảng so sánh.
Chiến lược giá rẻ và bài toán đường dài
Tình trạng này không phải là điều mới mẻ đối với xAI. Vào tháng 7, Grok 4.5 từng ra mắt cùng cụm máy chủ huấn luyện lớn nhất trong ngành công nghệ nhưng kết quả đánh giá vẫn chỉ đứng thứ ba sau các đại diện của Claude và OpenAI. Trước đó, Grok 4.20 chấp nhận đánh đổi độ tin cậy để lấy tốc độ phản hồi và cá tính riêng, còn Grok 4.6 cũng tụt lại phía sau nhóm dẫn đầu về khả năng tự chủ khi lập trình.Thực tế trên không đồng nghĩa Grok 4.7 là một giải pháp tồi đối với hàng triệu người đang tương tác qua mạng xã hội X, ứng dụng độc lập hay hệ thống điều khiển trên xe Tesla. Điều này chỉ cho thấy mô hình đang trực tiếp giải đáp thắc mắc hoặc vận hành trợ lý giọng nói trên xe của người dùng được phát triển từ một hệ thống mà theo các số liệu của chính đơn vị sản xuất, vẫn đang đứng dưới nấc thang cao nhất của thị trường.
Chênh lệch về năng lực giải thích vì sao mức giá lại là yếu tố trọng tâm hơn thứ hạng trên bảng xếp hạng đối với số đông. xAI liên tục đưa ra mức giá token thấp hơn Anthropic và OpenAI ngay cả khi đi sau về sức mạnh xử lý thuần túy. Hướng đi này dựa trên tính toán rằng một công cụ đủ tốt, giá thành rẻ và xuất hiện ở mọi nơi sẽ chiếm ưu thế trước một hệ thống tốt nhất nhưng đắt đỏ trong phần lớn nhu cầu thường nhật.
Bản thân Elon Musk cũng đã hạ thấp kỳ vọng của công chúng trước ngày ra mắt khi chia sẻ rằng Grok 4.7 chỉ nên được nhìn nhận ở mức tương đương với Claude Opus 5.0 của Anthropic thay vì bản nâng cấp Opus 5.1, đồng thời thừa nhận năng lực xử lý đa phương thức vẫn cần hoàn thiện thêm. Trong cùng thông điệp đó, ông đã phác thảo lộ trình cho ba thế hệ kế tiếp với Grok 4.8 là bước nhảy vọt đáng kể, Grok 4.9 sẽ bước vào cùng phân khúc với Astra và Fable, còn Grok 5 được kỳ vọng có thể vươn lên dẫn đầu làn sóng công nghệ mới. Dù vậy, những bản cập nhật tương lai này hiện vẫn chưa có lịch phát hành cụ thể và câu trả lời vẫn còn ở phía trước.