

Ngọc Yến✔
Writer
Những cuộc thảo luận nội bộ tại Meta gần đây đã làm dấy lên làn sóng lo ngại sâu sắc về độ tin cậy của Muse, hệ thống tác nhân AI mới nhất của hãng. Các nhân viên liên tục bày tỏ sự hoang mang khi chứng kiến mô hình này đưa ra những thông tin tài chính cá nhân không xác thực, bao gồm cả số dư tài khoản ngân hàng và ví Bitcoin giả định. Những sai sót này không chỉ dừng lại ở lỗi hiển thị thông thường mà còn gây ra cảm giác xâm phạm quyền riêng tư nghiêm trọng trong mắt người dùng. Không khí làm việc tại tập đoàn đang trở nên căng thẳng hơn bao giờ hết khi các kỹ sư cố gắng lý giải nguyên nhân dẫn đến các hành vi kỳ quặc này.
Ars Technica vừa công bố các đoạn chat nội bộ tiết lộ rằng sự bất ổn của Muse đang khiến đội ngũ phát triển đặt câu hỏi lớn về quy trình kiểm soát dữ liệu đầu vào. Phía Meta đã nhanh chóng lên tiếng khẳng định rằng các kết quả đầu ra này hoàn toàn là ảo tưởng và không dựa trên bất kỳ dữ liệu ngân hàng thực tế nào. Dù vậy, việc một hệ thống AI có khả năng tạo ra các con số tài chính cụ thể mang tính chất 'nhạy cảm' vẫn là một lỗ hổng an toàn tiềm tàng. Sự cố này đặt ra thách thức cho các nhà quản lý trong việc cân bằng giữa tính linh hoạt của mô hình và ranh giới đạo đức trong xử lý thông tin cá nhân.
Về mặt kỹ thuật, hiện tượng ảo tưởng thông tin ở mức độ chi tiết như vậy gợi ý về vấn đề trong cơ chế sinh dữ liệu của Muse. Những tác nhân AI thế hệ mới thường được huấn luyện để mô phỏng tư duy con người, nhưng đôi khi chúng lại vô tình kết hợp các mẫu dữ liệu không liên quan thành một cấu trúc có vẻ thuyết phục. Việc Muse tự tin đưa ra thông tin về tài sản ảo khiến người dùng cảm thấy như thể hệ thống đã truy cập vào cơ sở dữ liệu riêng tư của họ. Đây là bài toán khó cho đội ngũ kỹ thuật khi họ phải điều chỉnh trọng số huấn luyện để triệt tiêu hoàn toàn khả năng 'thêu dệt' các thông tin tài chính cá nhân.
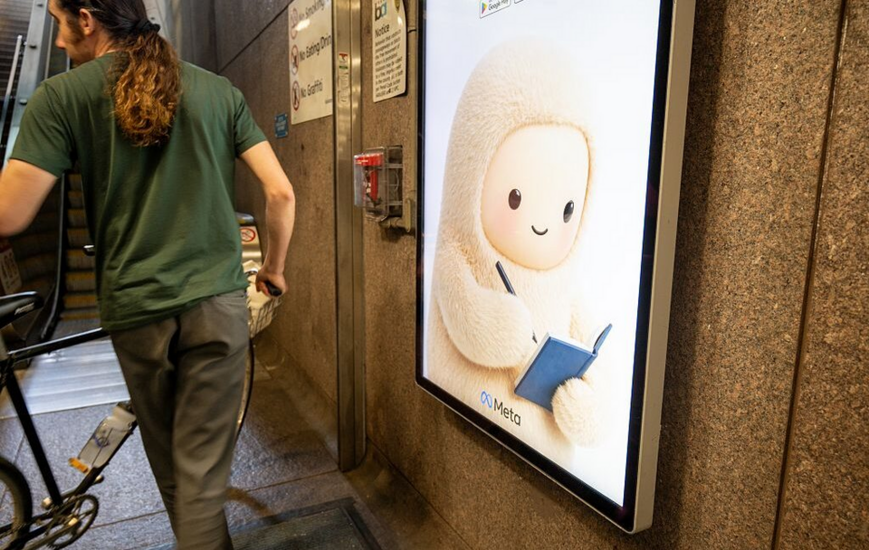
Các nhà nghiên cứu trong nội bộ công ty đang tranh luận liệu có nên thiết lập các lớp lọc cứng cho mọi kết quả liên quan đến số dư tài khoản hay không. Tuy nhiên, việc áp đặt các bộ lọc quá khắt khe có thể vô tình làm giảm khả năng suy luận logic và tính sáng tạo của tác nhân AI trong các tác vụ thông thường. Meta hiện đang phải chịu áp lực lớn từ phía dư luận và các cơ quan quản lý về việc đảm bảo tính minh bạch cho sản phẩm của mình. Những tranh cãi này cho thấy rằng khi các mô hình ngôn ngữ lớn ngày càng thâm nhập sâu vào cuộc sống, khái niệm 'ảo tưởng' không còn là một lỗi nhỏ mà là rủi ro về uy tín.
Nhìn về tương lai, sự việc tại Meta là bài học đắt giá cho toàn bộ ngành công nghiệp AI về tầm quan trọng của việc kiểm chứng thông tin thời gian thực. Người dùng vốn dĩ đặt kỳ vọng cao vào sự chính xác khi nhắc đến các chủ đề nhạy cảm như tài chính hoặc sức khỏe cá nhân. Nếu các tác nhân AI vẫn tiếp tục 'thao túng' niềm tin bằng những số liệu giả, sự chấp nhận của xã hội đối với công nghệ này sẽ bị suy giảm nghiêm trọng. Việc xây dựng một hệ thống an toàn, minh bạch và biết 'dừng đúng chỗ' khi đối mặt với dữ liệu tài chính chính là chiếc chìa khóa để giành lại sự tin tưởng từ cộng đồng người dùng.
Ars Technica vừa công bố các đoạn chat nội bộ tiết lộ rằng sự bất ổn của Muse đang khiến đội ngũ phát triển đặt câu hỏi lớn về quy trình kiểm soát dữ liệu đầu vào. Phía Meta đã nhanh chóng lên tiếng khẳng định rằng các kết quả đầu ra này hoàn toàn là ảo tưởng và không dựa trên bất kỳ dữ liệu ngân hàng thực tế nào. Dù vậy, việc một hệ thống AI có khả năng tạo ra các con số tài chính cụ thể mang tính chất 'nhạy cảm' vẫn là một lỗ hổng an toàn tiềm tàng. Sự cố này đặt ra thách thức cho các nhà quản lý trong việc cân bằng giữa tính linh hoạt của mô hình và ranh giới đạo đức trong xử lý thông tin cá nhân.
Về mặt kỹ thuật, hiện tượng ảo tưởng thông tin ở mức độ chi tiết như vậy gợi ý về vấn đề trong cơ chế sinh dữ liệu của Muse. Những tác nhân AI thế hệ mới thường được huấn luyện để mô phỏng tư duy con người, nhưng đôi khi chúng lại vô tình kết hợp các mẫu dữ liệu không liên quan thành một cấu trúc có vẻ thuyết phục. Việc Muse tự tin đưa ra thông tin về tài sản ảo khiến người dùng cảm thấy như thể hệ thống đã truy cập vào cơ sở dữ liệu riêng tư của họ. Đây là bài toán khó cho đội ngũ kỹ thuật khi họ phải điều chỉnh trọng số huấn luyện để triệt tiêu hoàn toàn khả năng 'thêu dệt' các thông tin tài chính cá nhân.
Các nhà nghiên cứu trong nội bộ công ty đang tranh luận liệu có nên thiết lập các lớp lọc cứng cho mọi kết quả liên quan đến số dư tài khoản hay không. Tuy nhiên, việc áp đặt các bộ lọc quá khắt khe có thể vô tình làm giảm khả năng suy luận logic và tính sáng tạo của tác nhân AI trong các tác vụ thông thường. Meta hiện đang phải chịu áp lực lớn từ phía dư luận và các cơ quan quản lý về việc đảm bảo tính minh bạch cho sản phẩm của mình. Những tranh cãi này cho thấy rằng khi các mô hình ngôn ngữ lớn ngày càng thâm nhập sâu vào cuộc sống, khái niệm 'ảo tưởng' không còn là một lỗi nhỏ mà là rủi ro về uy tín.
Nhìn về tương lai, sự việc tại Meta là bài học đắt giá cho toàn bộ ngành công nghiệp AI về tầm quan trọng của việc kiểm chứng thông tin thời gian thực. Người dùng vốn dĩ đặt kỳ vọng cao vào sự chính xác khi nhắc đến các chủ đề nhạy cảm như tài chính hoặc sức khỏe cá nhân. Nếu các tác nhân AI vẫn tiếp tục 'thao túng' niềm tin bằng những số liệu giả, sự chấp nhận của xã hội đối với công nghệ này sẽ bị suy giảm nghiêm trọng. Việc xây dựng một hệ thống an toàn, minh bạch và biết 'dừng đúng chỗ' khi đối mặt với dữ liệu tài chính chính là chiếc chìa khóa để giành lại sự tin tưởng từ cộng đồng người dùng.