

Nguyễn Hoàng✔
Administrator
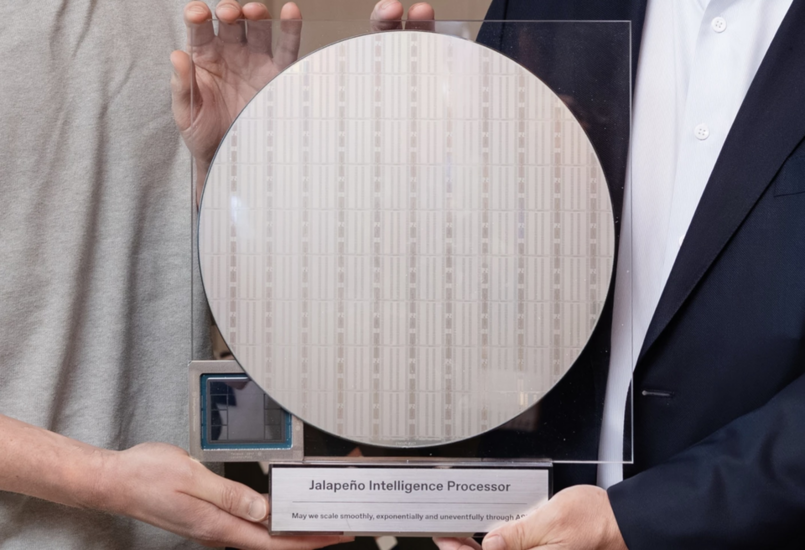
Trí tuệ nhân tạo vừa tiến thêm một bước dài trên con đường tự cải thiện chính nền tảng phần cứng nuôi sống mình khi phòng thí nghiệm hàng đầu thế giới công bố chi tiết năng lực tối ưu vi mạch bán dẫn cấp độ thực chiến. Theo báo cáo chuyên sâu vừa được OpenAI đăng tải với tựa đề 'Advancing chip design with OpenAI models', từ đầu năm 2025 đội ngũ kỹ sư của hãng đã bắt đầu dùng từ GPT-o3 mini tới các mô hình thế hệ mới hơn để tăng tốc thiết kế Jalapeño - con chip suy luận AI tùy biến đầu tiên của công ty - và kết quả tối ưu đã được xác thực thực tế khi đưa chip lên bàn thử nghiệm phần cứng (silicon bring-up).
Xét về chi tiết vi kiến trúc trên Jalapeño, các mô hình đã trực tiếp đề xuất phương án tái cấu trúc logic bộ cộng, bộ nhân dấu chấm động, logic quy gọn và cách chia tầng đường ống dẫn dữ liệu (pipeline). Trong khối tính toán ma trận (matrix unit), một thiết kế lại bộ nhân giúp giảm khoảng 15% diện tích ô mạch tổng hợp đồng thời rút ngắn độ trễ từ hai chu kỳ xung nhịp xuống còn một chu kỳ, còn một cải tiến bộ cộng khác cũng tiết kiệm khoảng 15% diện tích mà vẫn giữ nguyên độ trễ hai chu kỳ; tính chung toàn bộ dự án Jalapeño, AI giúp cắt giảm khoảng 13% diện tích khối vector và 10% khối ma trận.
Không chỉ áp dụng nội bộ, công nghệ viết lại mã mô tả phần cứng SystemVerilog RTL của hãng còn mang lại hiệu quả vượt mong đợi khi hợp tác trực tiếp với tập đoàn bán dẫn AMD. Trên những khối mạch IP GPU chủ lực vốn đã được kỹ sư con người tối ưu rất chặt chẽ, mô hình vẫn tìm ra cách cải thiện tới 14% chỉ số tổng hợp PPA (điện năng tiêu thụ, hiệu năng và diện tích), tương đương rút gọn khối lượng tiến bộ của cả một năm xuống còn chưa đầy 5 tháng; AMD thậm chí đã đưa một phần mã thiết kế do AI viết vào hồ sơ sản xuất thực tế cũng như ghi nhận mức tăng PPA một chữ số trên các khối CPU thế hệ kế tiếp.
Để đo lường mức độ tiến hóa năng lực thiết kế chip qua từng thế hệ mô hình, nhóm nghiên cứu đã thực hiện 9.881 lượt chạy chấm điểm trên hai lõi vi xử lý RISC-V 32-bit mã nguồn mở là PicoRV32 (dùng cho FPGA) và OpenTitan Ibex (dùng trong chip bảo mật), kết hợp công cụ Yosys ước tính tần số xung nhịp tối đa. Dưới ngân sách so sánh khoảng 112.000 token mỗi lượt chạy, mô hình GPT-6.2 Astra dẫn đầu tuyệt đối cả hai lõi khi đạt điểm thông lượng trung bình cao gấp đôi GPT-6 Astra trên thiết kế PicoRV32 sẵn có, và tiếp tục vượt ngưỡng 0,7 điểm trên PicoRV32 cùng khoảng 0,75 điểm trên Ibex khi tự thiết kế lõi mới từ đặc tả yêu cầu viết tay.
Đáng chú ý hơn cả, nghiên cứu khẳng định các mô hình đã bắt đầu suy luận RTL ở trình độ tương đương một kiến trúc sư vi mạch lão luyện khi tự biết dùng phần mềm kiểm định chuẩn công nghiệp để bảo toàn hành vi logic nguyên bản. Nhằm chuẩn hóa quy trình đánh giá và mở rộng phạm vi ứng dụng thực tế, OpenAI chính thức công bố hợp tác chiến lược cùng hãng công cụ thiết kế tự động hóa điện tử Synopsys để huấn luyện mô hình chuyên biệt mang tên GPT-Synopsys, giúp AI vận hành bộ phần mềm EDA theo đúng chuẩn mực kỹ sư bán dẫn chuyên nghiệp.
Xét về chi tiết vi kiến trúc trên Jalapeño, các mô hình đã trực tiếp đề xuất phương án tái cấu trúc logic bộ cộng, bộ nhân dấu chấm động, logic quy gọn và cách chia tầng đường ống dẫn dữ liệu (pipeline). Trong khối tính toán ma trận (matrix unit), một thiết kế lại bộ nhân giúp giảm khoảng 15% diện tích ô mạch tổng hợp đồng thời rút ngắn độ trễ từ hai chu kỳ xung nhịp xuống còn một chu kỳ, còn một cải tiến bộ cộng khác cũng tiết kiệm khoảng 15% diện tích mà vẫn giữ nguyên độ trễ hai chu kỳ; tính chung toàn bộ dự án Jalapeño, AI giúp cắt giảm khoảng 13% diện tích khối vector và 10% khối ma trận.
Không chỉ áp dụng nội bộ, công nghệ viết lại mã mô tả phần cứng SystemVerilog RTL của hãng còn mang lại hiệu quả vượt mong đợi khi hợp tác trực tiếp với tập đoàn bán dẫn AMD. Trên những khối mạch IP GPU chủ lực vốn đã được kỹ sư con người tối ưu rất chặt chẽ, mô hình vẫn tìm ra cách cải thiện tới 14% chỉ số tổng hợp PPA (điện năng tiêu thụ, hiệu năng và diện tích), tương đương rút gọn khối lượng tiến bộ của cả một năm xuống còn chưa đầy 5 tháng; AMD thậm chí đã đưa một phần mã thiết kế do AI viết vào hồ sơ sản xuất thực tế cũng như ghi nhận mức tăng PPA một chữ số trên các khối CPU thế hệ kế tiếp.
Để đo lường mức độ tiến hóa năng lực thiết kế chip qua từng thế hệ mô hình, nhóm nghiên cứu đã thực hiện 9.881 lượt chạy chấm điểm trên hai lõi vi xử lý RISC-V 32-bit mã nguồn mở là PicoRV32 (dùng cho FPGA) và OpenTitan Ibex (dùng trong chip bảo mật), kết hợp công cụ Yosys ước tính tần số xung nhịp tối đa. Dưới ngân sách so sánh khoảng 112.000 token mỗi lượt chạy, mô hình GPT-6.2 Astra dẫn đầu tuyệt đối cả hai lõi khi đạt điểm thông lượng trung bình cao gấp đôi GPT-6 Astra trên thiết kế PicoRV32 sẵn có, và tiếp tục vượt ngưỡng 0,7 điểm trên PicoRV32 cùng khoảng 0,75 điểm trên Ibex khi tự thiết kế lõi mới từ đặc tả yêu cầu viết tay.
Đáng chú ý hơn cả, nghiên cứu khẳng định các mô hình đã bắt đầu suy luận RTL ở trình độ tương đương một kiến trúc sư vi mạch lão luyện khi tự biết dùng phần mềm kiểm định chuẩn công nghiệp để bảo toàn hành vi logic nguyên bản. Nhằm chuẩn hóa quy trình đánh giá và mở rộng phạm vi ứng dụng thực tế, OpenAI chính thức công bố hợp tác chiến lược cùng hãng công cụ thiết kế tự động hóa điện tử Synopsys để huấn luyện mô hình chuyên biệt mang tên GPT-Synopsys, giúp AI vận hành bộ phần mềm EDA theo đúng chuẩn mực kỹ sư bán dẫn chuyên nghiệp.