

Mạnh Quân✔
Writer
Trong bối cảnh các mô hình ngôn ngữ lớn thường được tinh chỉnh để đạt hiệu năng tổng quát, việc áp dụng chúng vào các tác vụ cụ thể trong những môi trường phần mềm riêng biệt thường bộc lộ sự kém hiệu quả. Một bài phân tích chuyên sâu trên Hugging Face đã giới thiệu giải pháp Harness Adapters, cho phép người dùng tùy biến các mô hình yêu thích thông qua kỹ thuật học tăng cường (RL) để tối đa hóa hiệu suất và cắt giảm chi phí. Thay vì dựa vào khả năng suy luận chung, các adapter này được huấn luyện đặc biệt để tương thích hoàn hảo với môi trường thực thi và nhiệm vụ mà tác nhân AI đang đảm nhận.
Con số thực tế chứng minh cho thấy hiệu quả vượt trội khi thử nghiệm với mô hình Qwen3.8-27B. Khi sử dụng bộ khung (harness) 'pi', mô hình cơ sở chỉ đạt 39% điểm số trên Terminal-Bench 2.1 với mức tiêu thụ trung bình 2.9K token cho mỗi tác vụ. Tuy nhiên, bằng cách đóng băng các trọng số và thêm vào một LoRA adapter được huấn luyện bằng RL, điểm pass@1 đã tăng vọt lên 55% trong khi mức tiêu thụ token giảm đáng kể xuống còn 1.5K. Sự cải thiện này đến từ việc mô hình thực hiện suy luận chuẩn xác hơn ngay từ lần đầu tiên, gọi ít công cụ hơn và tối ưu hóa quy trình làm việc trong môi trường thực tế.
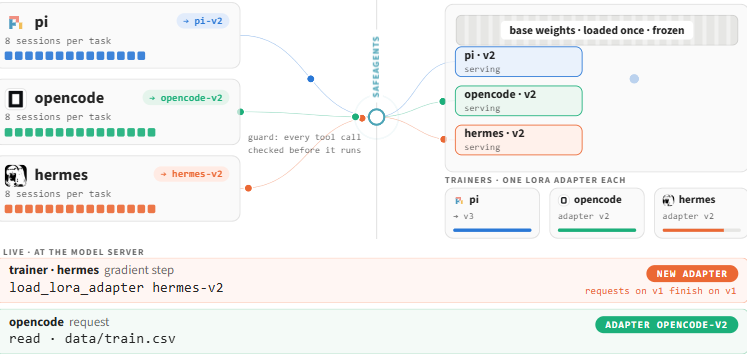
Phương pháp này không chỉ áp dụng cho một môi trường duy nhất mà còn được thử nghiệm thành công trên quy mô lớn với các bộ khung khác như OpenCode và Hermes Agent. Các chuyên gia đã xây dựng một bộ công thức tái sử dụng, cho phép cộng đồng thực hiện tương tự trên bất kỳ sự kết hợp nào giữa tác vụ, bộ khung và mô hình. Điểm nhấn kỹ thuật chính là việc huấn luyện một LoRA adapter riêng biệt cho mỗi bộ khung, sau đó hợp nhất chúng thành một 'super-adapter' duy nhất có khả năng chạy hiệu quả mà không cần thay đổi cấu trúc, đánh dấu một bước tiến trong khả năng linh hoạt của các hệ thống AI.
Cơ chế huấn luyện Harness Adapters tận dụng tối đa hệ sinh thái dữ liệu với các công cụ như TRL’s AsyncGRPOTrainer và OpenEnv để đảm bảo tính chính xác trong quá trình rollouts. Việc tạo tập dữ liệu tùy chỉnh cho các tác vụ lập trình của tác nhân AI được xây dựng công phu từ ba nguồn chính, bao gồm cả việc lọc bỏ dữ liệu trùng lặp và các tác vụ không phù hợp. Đặc biệt, bộ lọc kiểm tra độ khó sử dụng mô hình Qwen3.8-27B để đánh giá khả năng giải quyết tác vụ trước huấn luyện, đảm bảo rằng mỗi tác vụ đều mang lại tín hiệu học tập giá trị cho mô hình, thay vì các tác vụ quá dễ hoặc quá khó.
Hướng đi này đặt ra câu hỏi thú vị về việc mô hình thực sự học được gì trong quá trình huấn luyện RL bên trong các bộ khung tác nhân. Kết quả thực nghiệm cho thấy Harness Adapters không chỉ cải thiện độ chính xác mà còn tạo ra sự thay đổi trong hành vi của tác nhân, giúp chúng xử lý các thao tác hệ thống tệp và tuần tự hóa dữ liệu một cách tối ưu. Với việc công bố toàn bộ tài nguyên bao gồm adapter, GGUF và các plugin huấn luyện, cộng đồng hoàn toàn có thể tiếp cận công nghệ này để tạo ra những tác nhân AI chuyên biệt mạnh mẽ, hiệu quả hơn trong lĩnh vực kỹ thuật phần mềm.
Con số thực tế chứng minh cho thấy hiệu quả vượt trội khi thử nghiệm với mô hình Qwen3.8-27B. Khi sử dụng bộ khung (harness) 'pi', mô hình cơ sở chỉ đạt 39% điểm số trên Terminal-Bench 2.1 với mức tiêu thụ trung bình 2.9K token cho mỗi tác vụ. Tuy nhiên, bằng cách đóng băng các trọng số và thêm vào một LoRA adapter được huấn luyện bằng RL, điểm pass@1 đã tăng vọt lên 55% trong khi mức tiêu thụ token giảm đáng kể xuống còn 1.5K. Sự cải thiện này đến từ việc mô hình thực hiện suy luận chuẩn xác hơn ngay từ lần đầu tiên, gọi ít công cụ hơn và tối ưu hóa quy trình làm việc trong môi trường thực tế.
Phương pháp này không chỉ áp dụng cho một môi trường duy nhất mà còn được thử nghiệm thành công trên quy mô lớn với các bộ khung khác như OpenCode và Hermes Agent. Các chuyên gia đã xây dựng một bộ công thức tái sử dụng, cho phép cộng đồng thực hiện tương tự trên bất kỳ sự kết hợp nào giữa tác vụ, bộ khung và mô hình. Điểm nhấn kỹ thuật chính là việc huấn luyện một LoRA adapter riêng biệt cho mỗi bộ khung, sau đó hợp nhất chúng thành một 'super-adapter' duy nhất có khả năng chạy hiệu quả mà không cần thay đổi cấu trúc, đánh dấu một bước tiến trong khả năng linh hoạt của các hệ thống AI.
Cơ chế huấn luyện Harness Adapters tận dụng tối đa hệ sinh thái dữ liệu với các công cụ như TRL’s AsyncGRPOTrainer và OpenEnv để đảm bảo tính chính xác trong quá trình rollouts. Việc tạo tập dữ liệu tùy chỉnh cho các tác vụ lập trình của tác nhân AI được xây dựng công phu từ ba nguồn chính, bao gồm cả việc lọc bỏ dữ liệu trùng lặp và các tác vụ không phù hợp. Đặc biệt, bộ lọc kiểm tra độ khó sử dụng mô hình Qwen3.8-27B để đánh giá khả năng giải quyết tác vụ trước huấn luyện, đảm bảo rằng mỗi tác vụ đều mang lại tín hiệu học tập giá trị cho mô hình, thay vì các tác vụ quá dễ hoặc quá khó.
Hướng đi này đặt ra câu hỏi thú vị về việc mô hình thực sự học được gì trong quá trình huấn luyện RL bên trong các bộ khung tác nhân. Kết quả thực nghiệm cho thấy Harness Adapters không chỉ cải thiện độ chính xác mà còn tạo ra sự thay đổi trong hành vi của tác nhân, giúp chúng xử lý các thao tác hệ thống tệp và tuần tự hóa dữ liệu một cách tối ưu. Với việc công bố toàn bộ tài nguyên bao gồm adapter, GGUF và các plugin huấn luyện, cộng đồng hoàn toàn có thể tiếp cận công nghệ này để tạo ra những tác nhân AI chuyên biệt mạnh mẽ, hiệu quả hơn trong lĩnh vực kỹ thuật phần mềm.